

DeepTalk |具身智能技术路线全景(2022—2026):从动作表征到世界动作模型
2026-11-06
2026 年,机器人的评价基准已从单任务操作能力转向对未见环境的泛化能力:能否在一个从未见过的厨房中,仅凭一句自然语言指令完成长程任务。VLA(Vision-Language-Action,视觉-语言-动作)是过去四年这一领域最清晰的技术主线,它自始至终只回答一个问题:如何把互联网规模的语义知识,转化为真实世界中的闭环动作。
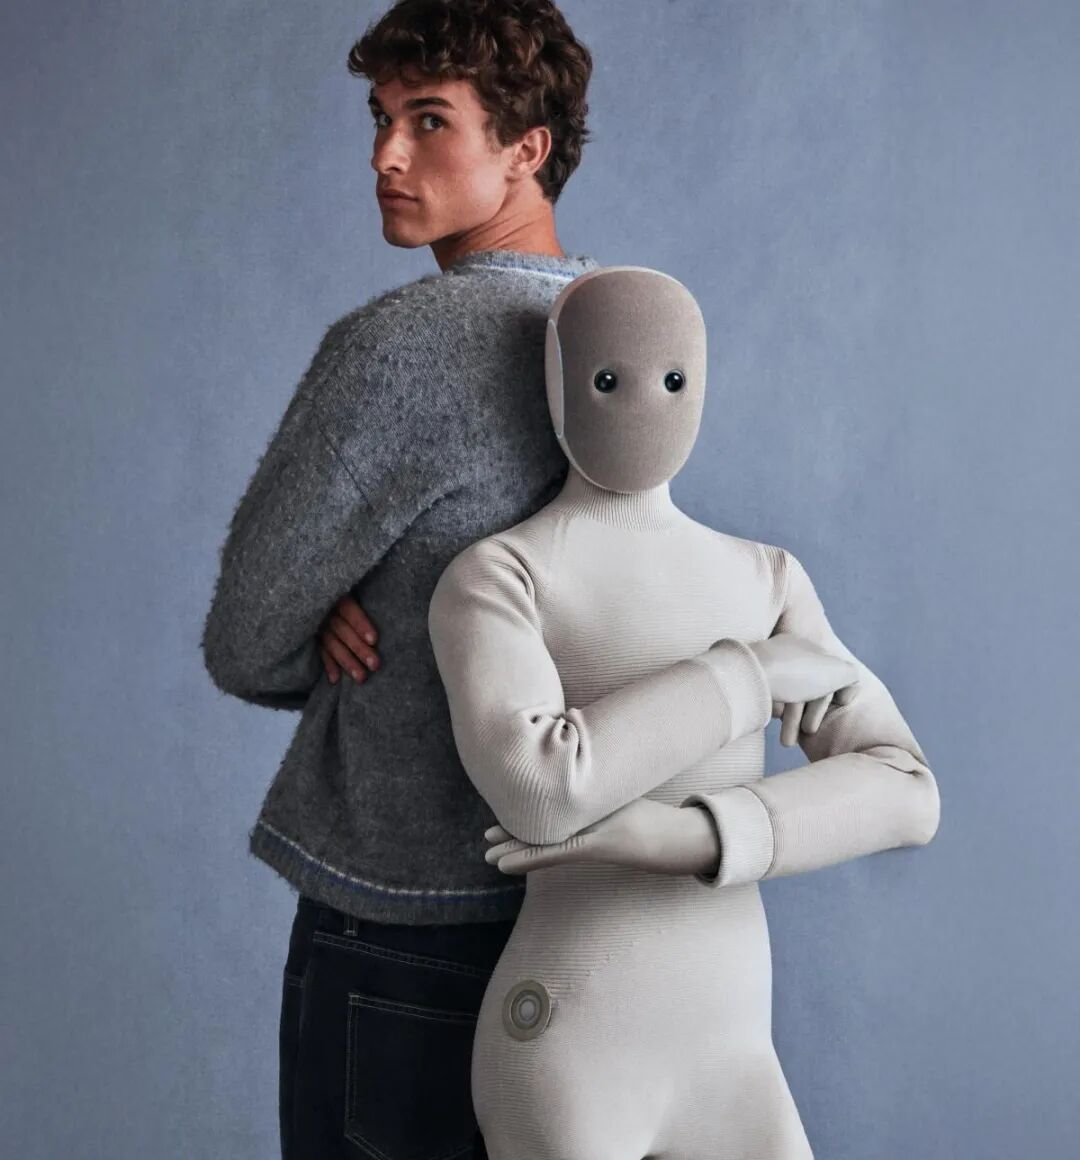
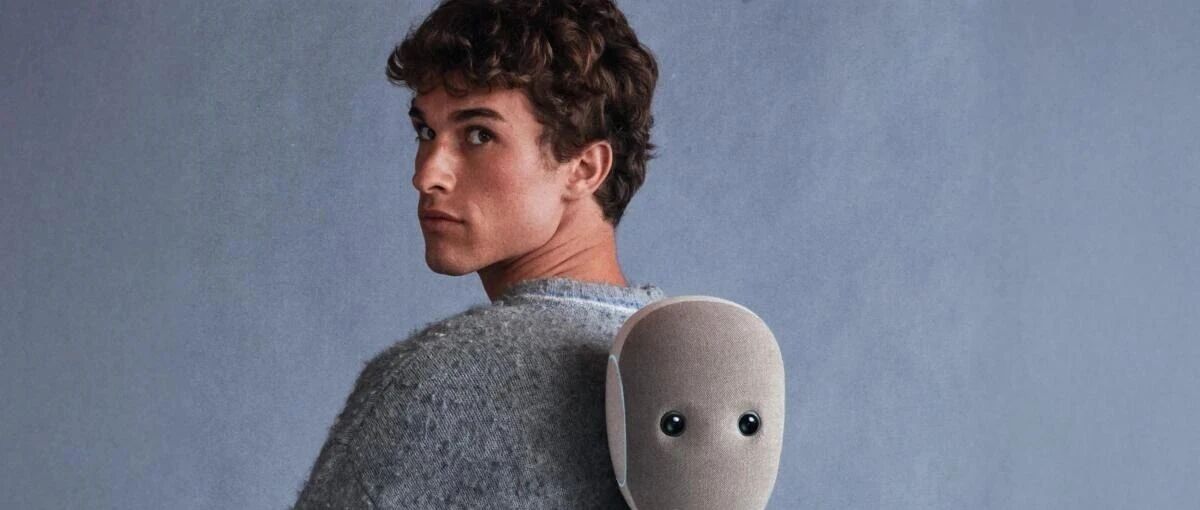
1X NEO 人形机器人(1X 官方产品图)
阶段一(2022—2023):从 SayCan 到 RT-2 的动作离散化
2022 年,Google 的 SayCan 首次让大语言模型参与机器人高层规划:LLM 将泡咖啡这一指令拆解为走向咖啡机、拿起杯子、按下开关等子步骤,价值函数对当前环境下各子步骤的可执行性进行评分,两者结合得到既可行又符合指令的动作序列。该方案分工清晰,但存在根本局限:LLM 无法感知图像,场景信息被压缩为单一标量,规划与现实之间始终存在人为设计的空隙。
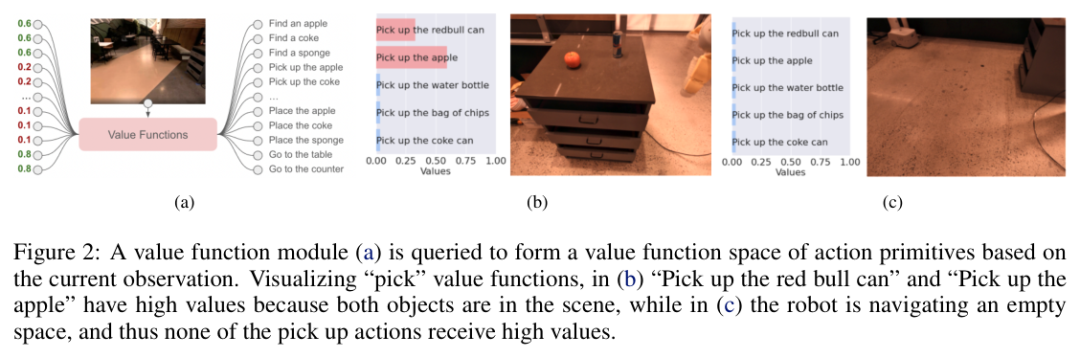
SayCan 论文 Figure 2:价值函数模块(a)依据当前观测为动作原语给出价值空间(b、c),用于判定各子步骤在当前环境中的可执行性
介于两者之间的过渡方案是 PaLM-E:Google 将图像直接编码进 562B 参数的具身多模态模型,验证了图像与语言的联合推理能力,但动作仍需下游策略执行,尚未实现端到端输出。
2023 年 7 月,RT-2 实现关键突破:将每个动作维度离散化为 256 个整数,与文本共享同一词表,直接微调 55B 规模的视觉语言模型,使动作在模型中被视为与文本同构的语言模态,与互联网级图文数据联合训练。VLA 这一术语由此确立,机器人首次能够借助语言模型中数以亿计的网络知识推理物理世界。在未见过的任务上,RT-2 任务成功率达到 62%,约为上一代 RT-1(32%)的两倍;代价是推理频率仅 1–3 Hz,每步仅输出一个动作 token,无法支撑高频精细操控。
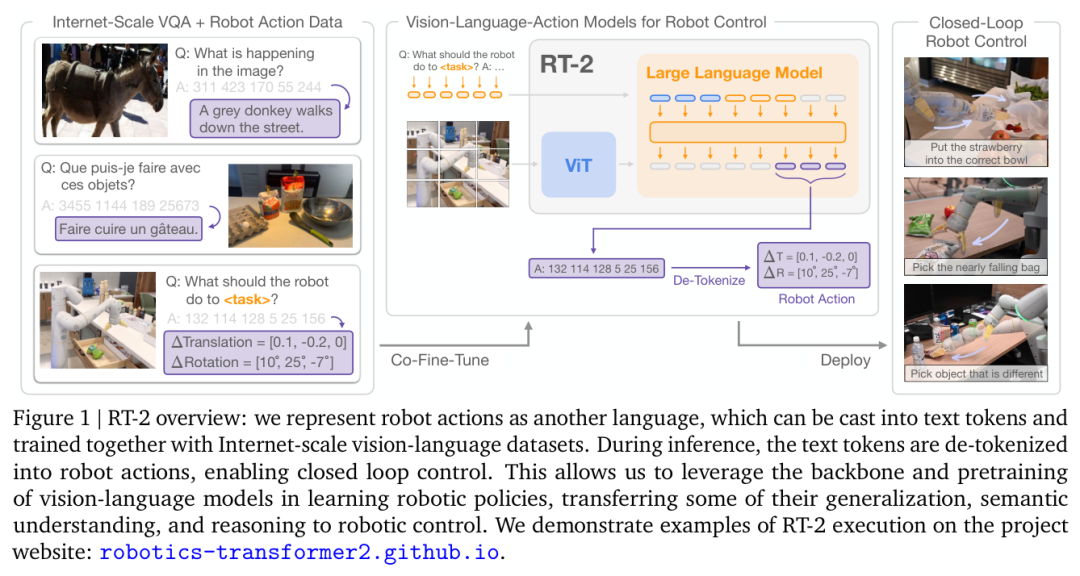
RT-2 论文 Figure 1:将机器人动作表示为与文本同构的语言模态,与互联网级视觉语言数据联合训练
阶段二(2024):开源复现与连续动作生成
2024 年上半年,Octo 使用 80 万条轨迹训练开源通用策略,以扩散头输出动作块,重点验证多本体适配与开放权重。
2024 年 6 月,OpenVLA 以同样的 256-bin 离散化范式开源复刻 7B 模型(DINOv2 + SigLIP 视觉编码 + LLM 骨干),在 Bridge 基准上以 70.6% 的成绩反超闭源的 RT-2-X,并给出消费级微调方案:LoRA 微调仅需约 60 GB 显存,单张 A100 即可完成训练。开源将这条技术路线的复现成本,从数十万 TPU 小时直接降至单卡量级。
同年 10 月,Physical Intelligence 的 π0 引入另一种动作表示方案:不再逐 token 生成动作,而是通过 flow matching 一次性生成 50 步连续动作块,3B 参数模型在 RTX 4090 上仅需 73 ms,单卡即可达到约 50 Hz。动作表示从离散 token 转向连续轨迹,并在 7 种本体、68 项任务上首次得到验证,这是 VLA 发展中最重要的一次范式迁移。
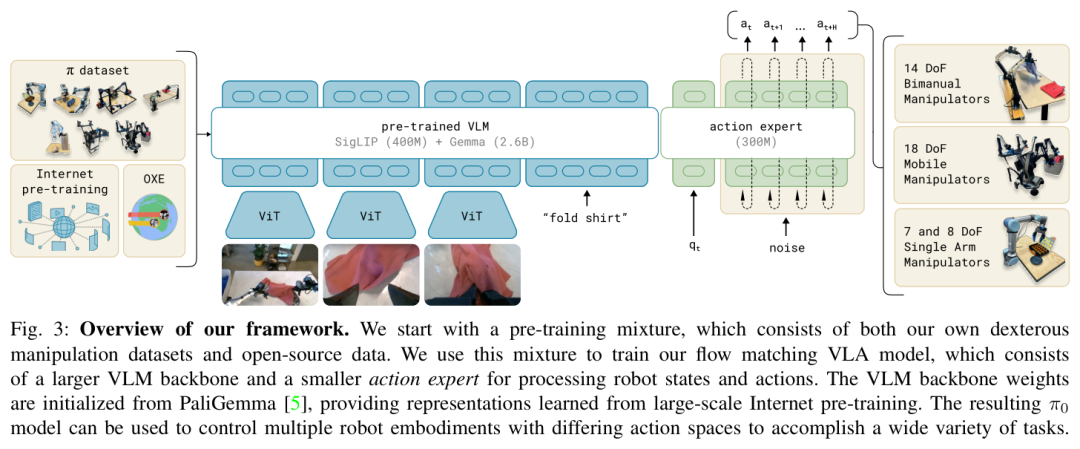
π0 论文 Fig. 3:以预训练 VLM 为骨干、通过 flow matching 输出连续动作块的框架总览
阶段三(2025—2026):基础模型、快慢系统与强化学习
2025 年起,核心问题转向长时程家庭部署:如何让模型进入真实家庭并完成持续性任务。各厂商的进展可归纳为五个方面。
·动作生成效率:π0-FAST 以 DCT+BPE 将高频动作压缩至约 30 token/秒,训练速度提升 5 倍;代价是 token 化推理需 750 ms,约为动作块方案的 10 倍;
·训练配方:π0.5 提出混合训练策略,即预训练采用 FAST、后训练换回 flow matching,模型首次在约 100 个真实家庭中完成家务任务;可用环境从 13 个扩展至 87 个时,平均任务进度提升数倍;
·快慢系统架构:Hi Robot 与 Figure Helix 02 将快慢系统工程化:高层 System 2 负责任务规划,底层 System 1 以 200 Hz 输出动作;Figure 以 1 kHz 的学习控制器替换了逾 10 万行手写 C++ 控制代码;
·长程记忆:MEM 采用两级记忆机制(视频编码器 + 语言摘要)扩展上下文,使模型能够保留数分钟前的交互状态;
·强化学习与数据复用:RTC 基于 inpainting 解决边执行边生成时的动作块拼接问题,此后成为 π 系列训练的标准组件;π*0.6 / RECAP 引入强化学习:仅需标注单条 episode 的成功或失败,即可将稀疏奖励转化为上万帧的逐帧监督信号,机器人据此连续执行 13 小时煮咖啡任务。
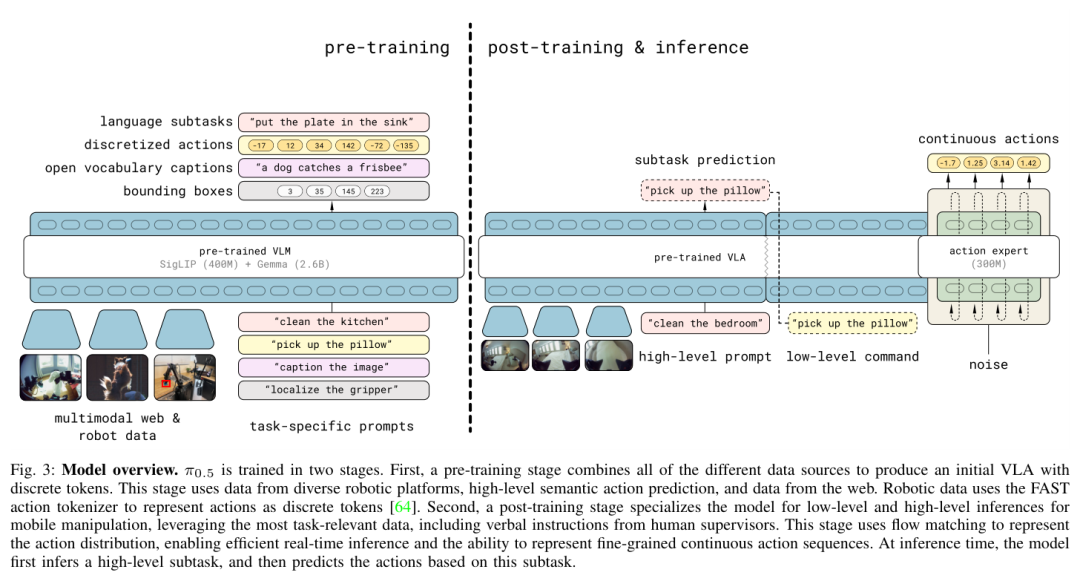
π0.5 论文 Fig. 3:预训练(FAST)与后训练(flow matching)两阶段的模型总览
到 2026 年,规模效益与通用性充分显现:π0.7 以 5B 参数、无需任务微调即可完成叠衣服与煮咖啡;Google Gemini Robotics 2 将 VLA 扩展至全身人形控制,灯泡更换任务成功率 92%,并同时发布 ER 2(云端强推理)与 On-Device 2(端侧低延迟)两个衍生模型;Figure Helix 02 采用 S0(1 kHz)/S1(200 Hz)/S2 三层架构,同时实现全身平衡控制与高层任务理解;英伟达 GR00T N2 转向世界-动作模型(WAM),在未见任务上的成功率较上一代提升一倍以上。
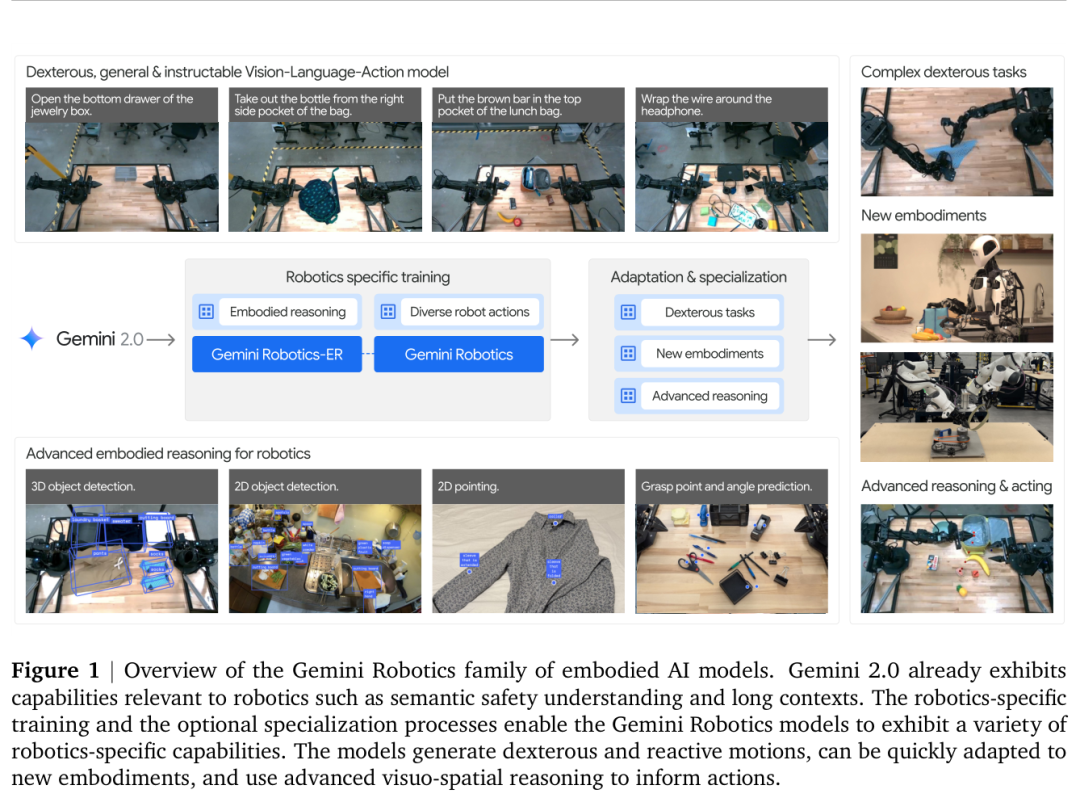
Google Gemini Robotics 论文 Figure 1:具身 AI 模型家族总览:2D/3D 检测、抓取点预测等能力叠加于统一多模态大模型(论文 2025-03)
平行路线:世界模型的三种路径
VLA 之外,还存在一条长期独立演化的技术线:世界模型。其内部又分为三个流派。
Dreamer 系最早起步,选择在潜空间中重建世界:以循环状态模型学习环境动力学,再在想象式 rollout 中完成规划。DreamerV3 以一套固定超参数覆盖 150+ 任务并发表于 Nature,是潜空间想象训练中最具代表性的动作策略方案。
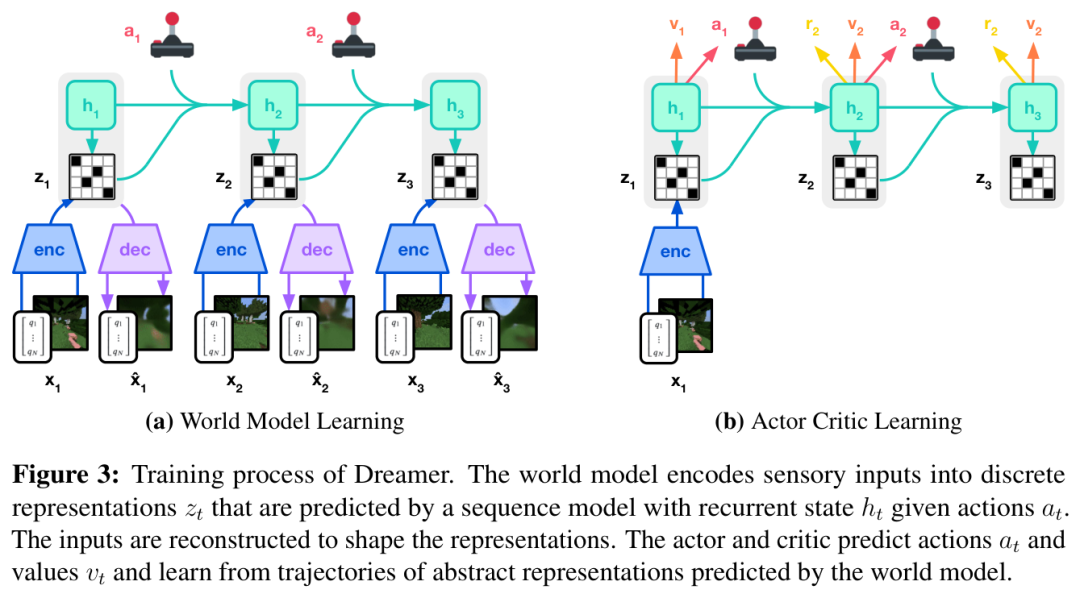
DreamerV3 论文 Figure 3:在潜空间想象中训练的策略与价值网络,世界模型先学习环境动力学
JEPA 系不重建像素,直接在表征空间预测未来。V-JEPA 2 以约 100 万小时网络视频完成预训练,机器人即可零样本规划,连续动作长达 16 秒。轻量方案还包括 DINO-WM(冻结 DINOv2 特征直接规划)与仅 15M 参数、单卡数小时即可训完的 LeWorldModel。
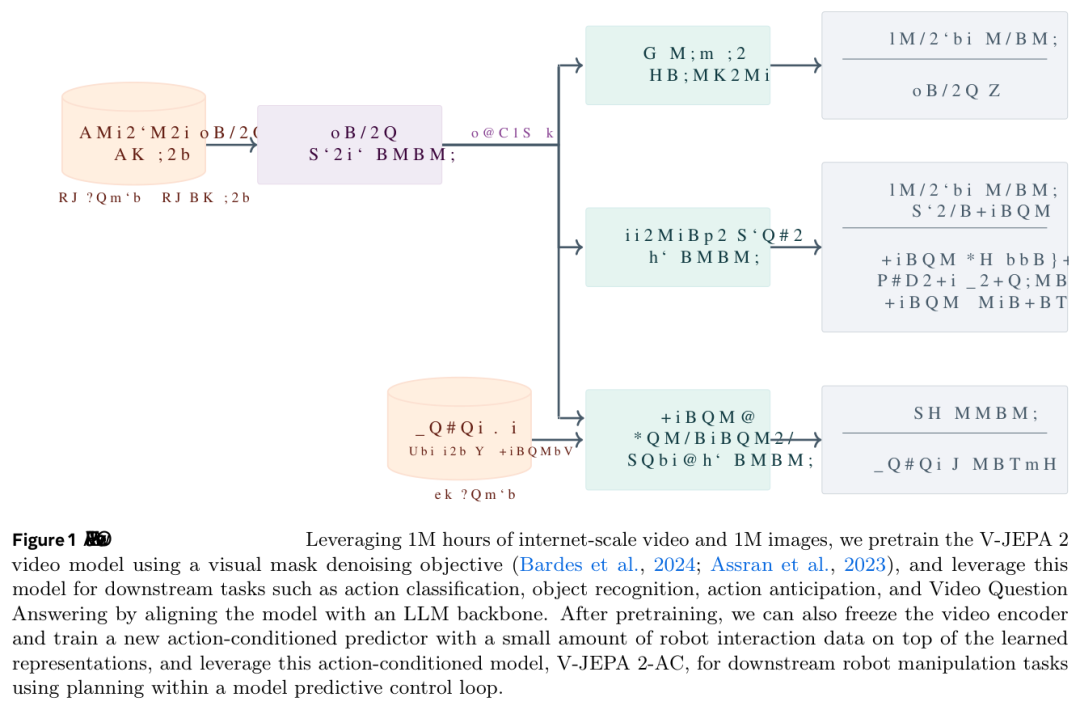
V-JEPA 2 论文 Figure 1:以百万小时视频预训练,在表征空间预测未来(不重建像素)
Cosmos 系投入最高,以视频生成构建物理先验:Cosmos 1 动用 1 万张 H100 连续训练 3 个月;到 Cosmos 3,动作已成为与语言、图像、视频、音频并列的基座模态。
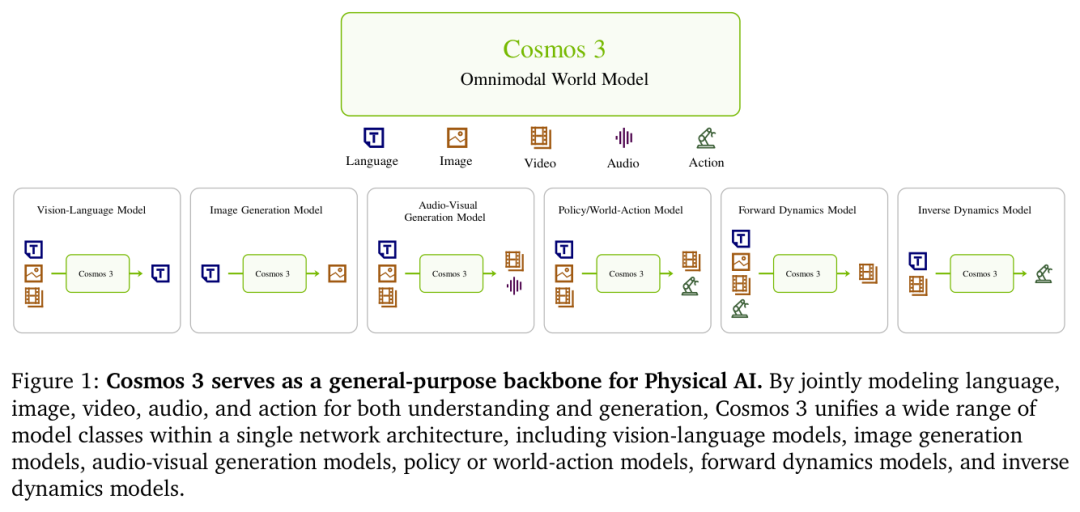
Cosmos 3 论文 Figure 1:将语言、图像、视频、音频与动作统一为基座模态
三条技术线此前基本互不交叉,2026 年出现明显收敛:1X 以 14B 视频模型预测未来并反解出动作,π0.7 的子目标图也由轻量世界模型生成。业界将其概括为 VLA + 世界模型的融合,或更进一步的世界动作模型(WAM)。
产业侧:三条公司路线
从产业视角看,各公司的技术路线选择可归纳为三类:
·路线 A,纯 VLA 扩展:π 系列、Gemini Robotics 2、Figure Helix 02、智元。核心假设是数据规模与 scaling 成效仍未见顶;
·路线 B,VLA + 世界模型:1X、Tesla、银河通用。策略网络提供先验,世界模型补充动力学建模;
·路线 C,世界动作模型:英伟达 GR00T N2 / Cosmos 3、Meta V-JEPA、星海图 Fast-WAM。核心假设是掌握世界演化规律后,动作能力将自然涌现。
多数公司实际采用混合路线,三条技术线正在收敛。
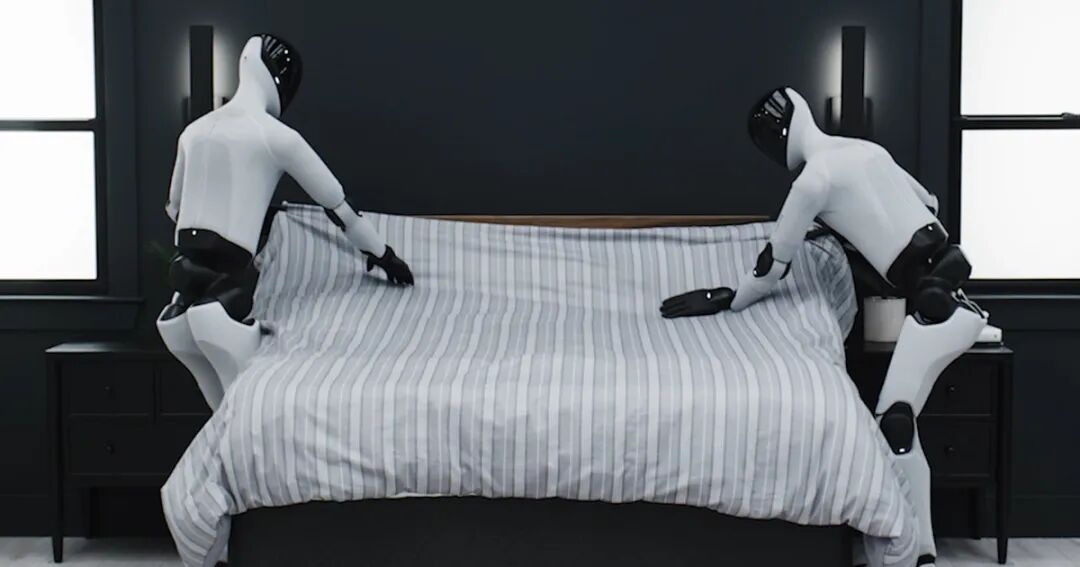
Figure 人形机器人在家中执行整理任务(Figure 官方图)
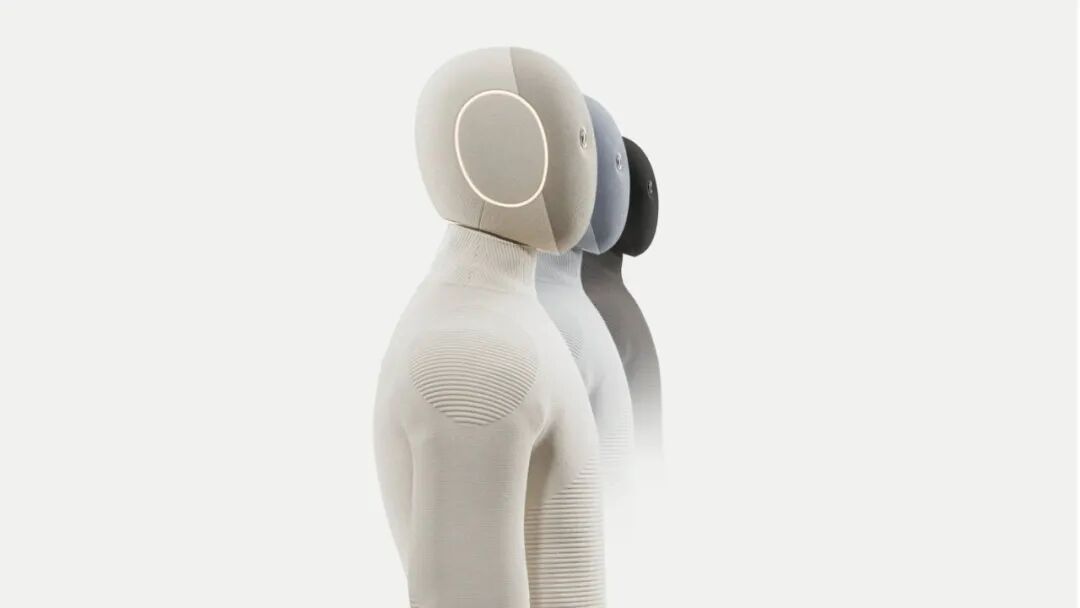
1X 官网发布图(1X 官方)
深兰的路线判断:大模型智能体驱动的新一代机器人
把 VLA 与世界模型放在一起看,两者各有侧重:VLA 解决的是语义到动作的映射,使机器人能够理解一句自然语言指令并直接输出动作;世界模型解决的是物理直觉,使模型能够先在潜空间或表征空间里推演未来。但两者本质上仍停留在动作生成层,回答的是动作该怎么做,却没有回答一整个任务该由谁来拆解、组织、监督与纠错。
商用机器人真正面对的,恰恰是后一个问题。一次清洁、配送或巡检任务,往往需要把一句模糊的意图拆成几十步可执行动作,中途调用不同工具与传感器,遇到失败后重新规划,并将数分钟乃至数小时前的状态保留在上下文里。任务分解、工具调用、长程记忆与失败自纠,正是大模型智能体架构的核心能力所在。
因此深兰认为,大模型智能体驱动的新一代机器人,比单纯的 VLA 扩展或世界模型路线更具发展前景:以通用大模型作为任务大脑,负责理解意图、拆解任务、规划与反思;以成熟的运动控制与执行系统作为小脑,负责把每一步动作稳定做出来;VLA 与世界模型则作为大脑指挥下的动作增强层,随成熟度逐步接入。这一分工对算力与数据的依赖更低、在商用场景中的落地速度更快、复利周期也更短:机器人可以先靠智能体稳定完成长时程任务,再逐步叠加更强的动作生成与物理预测能力。
·长程规划:VLA 以单步或短动作块为主,世界模型聚焦未来状态预测,大模型智能体原生支持任务分解与多步规划;
·物理直觉:世界模型最强,VLA 依赖数据隐式学习,智能体需借助工具调用与执行层补齐;
·数据与算力依赖:端到端 VLA 与世界模型依赖大规模数据与算力,智能体架构可复用通用大模型能力,对执行层数据要求更低;
·商业落地速度:智能体可在现有商用机器人平台上先落地,VLA 与世界模型更多作为后续增强层接入。
多数公司仍在纯 VLA 与世界模型之间做取舍,我们的选择是把智能体放在架构中心:先解决机器人能不能规划、能不能稳定执行长时程任务,再解决动作够不够精细、物理直觉够不够准。对商用机器人而言,这是更贴合产品化节奏的一条路径。
-

【央视新闻】深兰熊猫公交亮相首部反映交通运输业史诗纪录片《交通中国》
媒体报道 -

树洞救援武汉中心正式挂牌,深兰用平台和技术为公益赋能
公司新闻 -

浦东创投集团参与完成深兰科技数亿元Pre-IPO轮投资
公司新闻 -

持续霸榜MedBench!深兰科技医疗大模型综合评测第一
公司新闻 -

强强联合!中兴通讯联合深兰科技发布新一代成熟商用“AI问诊助手智能体”全场景解决方案,惊艳亮相2025世界人工智能大会
公司新闻 -

全球首发!深兰科技AI玩偶:读懂孩子情绪,开启“人机共育”育儿新时代!
公司新闻 -

智启新程,科创未来|热烈祝贺深兰科技集团新总部启用
公司新闻 -

深兰科技与伊拉克国家基建发展基金会达成全方位合作:以AI技术全面助力伊拉克国家重建与民生发展
公司新闻 -
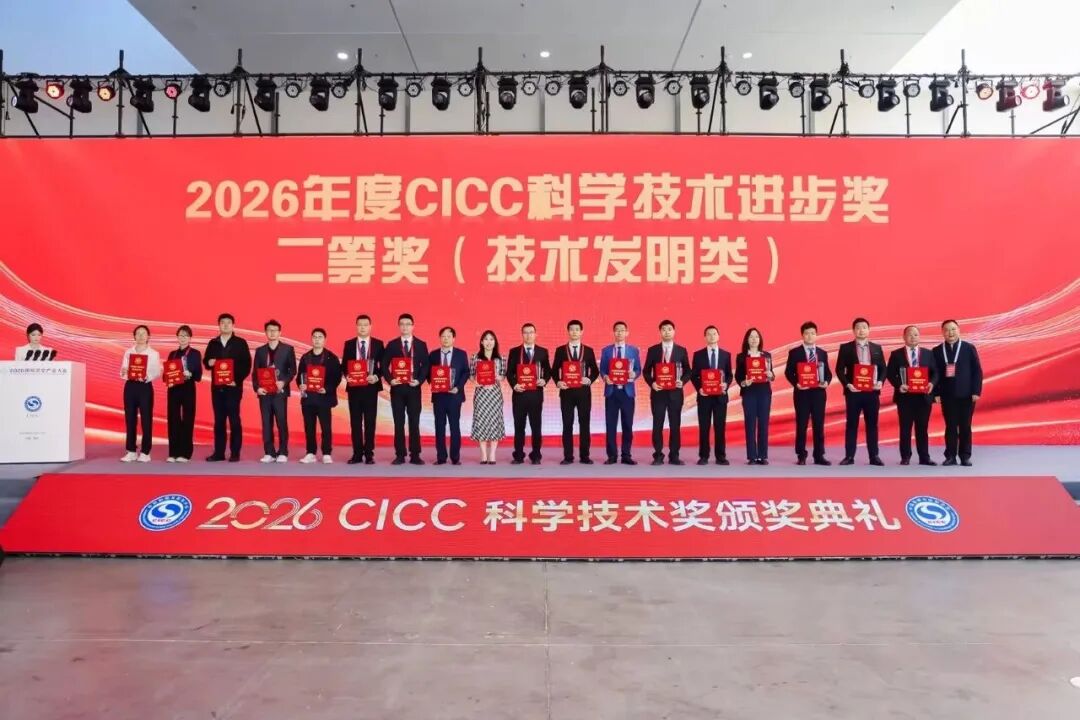
国家权威学会奖项!深兰科技荣获2026年度CICC科学技术进步奖二等奖
公司新闻 -
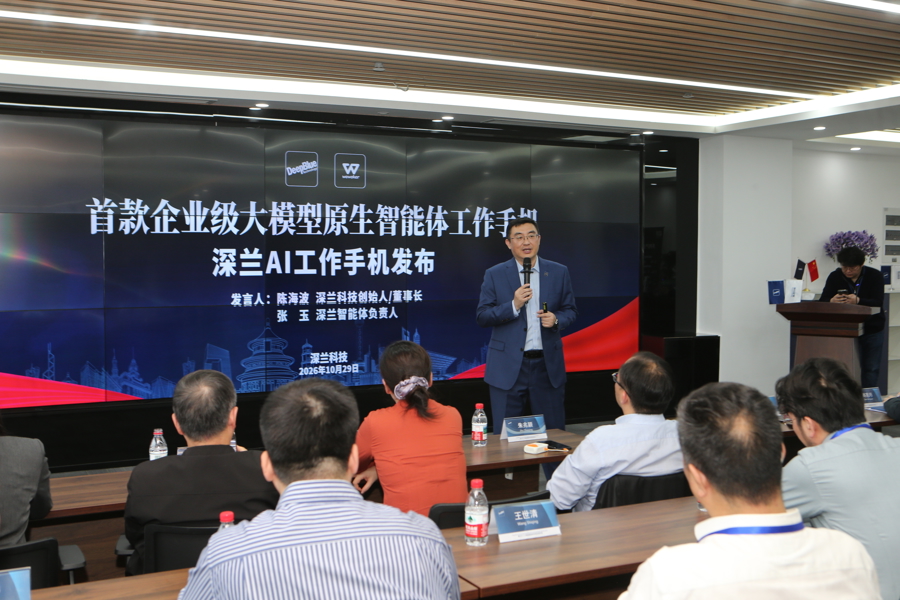
【文汇报】全球首款大模型智能体工作手机!这家公司联合华为共同打造
公司新闻 -

【新华社】智能体手机市场升温 业界探索企业级市场应用
媒体报道 -
【人民日报】“数字员工”走进业务一线,深兰科技企业级AI工作终端落地商用
媒体报道 -
【经济日报】深兰科技推出大模型AI智能体工作手机
媒体报道 -
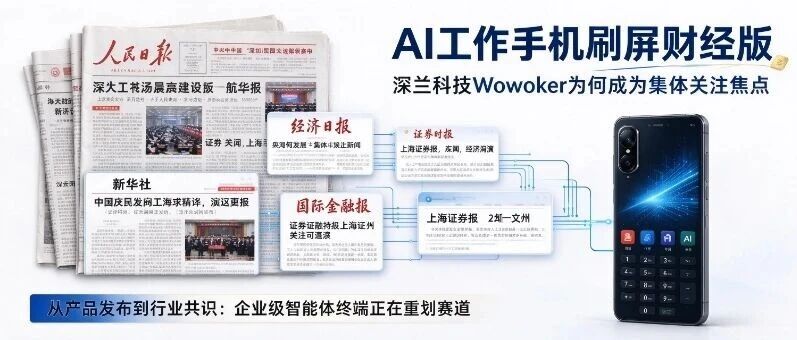
人民日报、经济日报等多家主流媒体聚焦深兰科技AI工作手机Wowoker
公司新闻 -
《巴黎协定》生效十周年,深兰科技获颁“全球气候一堂课1㎡气候实验室”认证,以AI赋能可持续校园活动
公司新闻 -
DeepTalk |具身智能技术路线全景(2022—2026):从动作表征到世界动作模型
公司新闻